Kubernetes monitoring: van node-metrics naar checkout-latency
Een cluster dat groen kleurt terwijl de checkout drie seconden hangt, is niet gemonitord. Het is versierd. Wij richten Kubernetes monitoring in op de vragen die geld kosten: lopen orders door, groeit de queue, haalt PHP-FPM het nog, en merkt de bezoeker iets? Het vaste team bouwt de stack, schrijft de alerts en kijkt mee als er iets afgaat.
- kube-prometheus-stack, Loki en Grafana als code in Git
- Metrics voor PHP-FPM, Varnish, Valkey, queues en cron
- Alerts op symptomen, niet op elke CPU-piek
Wat is Kubernetes monitoring, en waarom is de standaardinstallatie niet genoeg?
Kubernetes monitoring is het verzamelen van metrics, logs en traces uit je cluster en je applicaties, zodat je ziet wat er gebeurt en een melding krijgt voordat klanten het merken. De gangbare open source stack bestaat uit Prometheus voor metrics, Alertmanager voor meldingen, Grafana voor dashboards en Loki voor logs. OpenTelemetry voegt traces toe: de route van één request door al je services.
Wie de Helm-chart kube-prometheus-stack installeert, heeft binnen een uur tientallen dashboards. Nodes, pods, geheugen, netwerk. Allemaal nuttig voor het platform, maar ze beantwoorden niet de vraag die een webshop stelt. Een pod kan prima draaien terwijl alle PHP-FPM-workers bezet zijn. De queue kan uren achterlopen zonder dat er één container herstart.
Op deze pagina leggen we uit hoe wij monitoring opbouwen voor Magento- en Laravel-platformen op Kubernetes: welke componenten, welke metrics per laag, welke alerts we standaard inrichten, hoe logs en traces passen, en waar real user monitoring zoals RUMvision het plaatje afmaakt. Ook eerlijk: wanneer een SaaS-oplossing slimmer is dan alles zelf draaien.
De stack: welke component doet wat
Alles open source en declaratief, zodat het met Argo CD mee-deployt als de rest van je platform.
| Component | Rol | Wat je ermee doet | Let op |
|---|---|---|---|
| Prometheus (via Prometheus Operator) | Metrics ophalen en opslaan | Scrapet exporters en applicaties via ServiceMonitor- en PodMonitor-resources | Lokale opslag is voor dagen of weken; voor lange retentie Thanos of Grafana Mimir |
| Alertmanager | Meldingen routeren | Groepeert, dempt en stuurt alerts naar Slack, e-mail of een on-call-tool | Zonder routing en inhibit-regels krijg je bij één storing twintig meldingen |
| Grafana | Dashboards en exploratie | Eén plek voor metrics, logs en traces, gekoppeld via datasources | Dashboards als JSON in Git, niet met de hand in de UI |
| Loki | Logs opslaan en doorzoeken | Indexeert alleen labels, de logregels zelf gaan naar object storage | Te veel labels (zoals order-ID) maakt Loki traag en duur |
| Grafana Alloy | Collector voor logs, metrics en traces | Leest containerlogs en stuurt ze naar Loki, ontvangt OTLP-traces | Promtail is sinds 2 maart 2026 end-of-life; nieuwe installaties gebruiken Alloy |
| OpenTelemetry | Traces en standaard telemetrie | PHP-extensie plus SDK geeft spans per request, database-query en externe call | Sampling instellen, anders groeit de opslag harder dan je verkeer |
| Tempo of Jaeger | Traces opslaan | Trace-ID's vanuit logregels aanklikken in Grafana | Optioneel: begin met metrics en logs, voeg traces toe als je services hebt |
Plan een vrijblijvend gesprek over je project
Een half uur via video met de mensen die het werk ook echt doen. Kies hieronder een moment dat jou past.
- Direct met het vaste team, geen tussenlagen
- Concrete feedback op je huidige situatie of plannen
- Eerlijk advies, ook als het antwoord "niet doen" is
- Indicatie van kosten en tijdlijn
Plan een gratis Tech Check
Vrijblijvend jouw uitdagingen bespreken
Of bel direct: 0591-239 299
Wat je meet per laag: van node tot checkout
Wij werken van boven naar beneden. De bovenste laag bepaalt of je wakker wordt gebeld, de onderste laag vertelt waarom.
Bedrijfsmetrics
- Orders per kwartier, vergeleken met hetzelfde tijdvak vorige week
- Checkout-latency per stap: winkelwagen, verzending, betaling, bevestiging
- Foutpercentage op betaal-callbacks en order-API's
- Mislukte betalingen per provider
- Zoekopdrachten zonder resultaat, als signaal dat OpenSearch hapert
Applicatie: Magento en Laravel
- PHP-FPM: actieve en wachtende processen, listen queue, max children reached
- Responstijden per route of controller, als histogram met p95 en p99
- Queue-lengte en wachttijd per queue: Magento-consumers, Laravel Horizon
- Cron: laatste geslaagde run per job, jobs met status error of missed
- Varnish: hit-ratio, backend-fouten en purges
Afhankelijkheden
- Valkey of Redis: geheugen, evictions, verbonden clients, latency
- OpenSearch: clusterstatus, heap, zoeklatency en indexeringsachterstand
- MySQL of MariaDB: verbindingen, trage queries, replicatievertraging
- RabbitMQ, als je die gebruikt: berichten in queue, consumers, unacked
- Externe API's: responstijd en fouten van ERP, PIM en betaalproviders
Kubernetes en infrastructuur
- Pods die herstarten, OOMKilled-events en pods in Pending
- CPU-throttling per container, niet alleen CPU-gebruik
- Geheugengebruik ten opzichte van requests en limits
- Node-capaciteit, schijfdruk en volumes die vollopen
- Certificaten die binnen 14 dagen verlopen
Magento op Kubernetes monitoren: de metrics die de standaard mist
Magento heeft geen ingebouwd /metrics-endpoint. Dat lossen we op met exporters naast de applicatie. PHP-FPM krijgt een status-pagina (pm.status_path) en een php-fpm-exporter als sidecar in dezelfde pod. Die levert per pod het aantal actieve, idle en wachtende processen. Staat de listen queue structureel boven nul, dan wachten requests op een vrije worker. Dat zie je eerder dan een stijgende responstijd.
Varnish draait bij ons als eigen Deployment en krijgt een varnish-exporter. De hit-ratio vertelt of je full page cache werkt. Zakt die na een deploy, dan purget iets te breed of zijn er cookies die caching blokkeren. Voor Valkey of Redis gebruiken we de redis_exporter; die werkt met beide, omdat Valkey het Redis-protocol spreekt. Evictions op de cache-database zijn normaal, evictions op de sessiedatabase niet.
Cron en queues zijn de plekken waar Magento stilletjes faalt. Cron draait als CronJob of als losse Deployment met bin/magento cron:run. We meten de tabel cron_schedule via een SQL-exporter: hoeveel jobs staan op error of missed, en wanneer draaide indexer_reindex_all_invalid voor het laatst goed. Queue-consumers draaien als Deployments. Gebruik je de MySQL-queue, dan tellen we openstaande berichten in queue_message_status. Gebruik je RabbitMQ, dan levert de ingebouwde Prometheus-plugin van RabbitMQ de cijfers direct.
Checkout-latency halen we niet uit gemiddelden. We meten de responstijd van de checkout-routes als histogram, uit de webserver-logs of uit OpenTelemetry-spans. Een gemiddelde van 400 milliseconden kan een p99 van vier seconden verbergen, en die vier seconden zijn precies de klanten die afhaken. Meer over de opbouw van zo'n shop staat op onze pagina over Magento op Kubernetes.
Laravel op Kubernetes monitoren: queues, Horizon en de scheduler
Bij Laravel zit het meeste risico in achtergrondwerk. Orders worden via jobs naar het ERP gestuurd, mails gaan via de queue, imports draaien 's nachts. Horizon geeft je een dashboard, maar dat dashboard belt niemand op. Daarom exporteren we de queue-lengte en wachttijd naar Prometheus, per queue. Op Redis of Valkey gaat dat via de lengte van de lijsten die Laravel gebruikt. Dezelfde metric voedt ook de autoscaling met KEDA.
De scheduler draait als CronJob met php artisan schedule:run, of als Deployment met schedule:work. In beide gevallen wil je weten of taken echt draaien. Kubernetes meldt alleen of de container slaagde, niet of jouw taak iets deed. We laten belangrijke taken een heartbeat sturen, of we meten de leeftijd van de laatste succesvolle run. Een alert op 'nachtelijke import is meer dan 26 uur oud' is concreter dan een alert op een mislukte pod.
Draai je Laravel Octane met FrankenPHP, Swoole of RoadRunner, dan veranderen de metrics. Er is geen PHP-FPM-pool meer, wel workers die lang leven. Daar letten we op geheugengroei per worker en op het aantal requests per worker voordat die herstart. Een geheugenlek dat bij PHP-FPM onzichtbaar bleef, wordt bij Octane een OOMKill.
Alerts die ertoe doen: onze standaardset
Elke alert heeft een eigenaar, een drempel die we kunnen onderbouwen en een runbook-link. Geen alert zonder actie.
Alerts op CPU boven 80 procent sturen we standaard niet uit. CPU is een oorzaak, geen symptoom. Een cluster op 85 procent dat snel antwoordt, is een efficiënt cluster. We alerten op wat de bezoeker of de operatie merkt, en gebruiken infrastructuurmetrics om de oorzaak te vinden.
Alertmanager stellen we in met groepering per cluster en namespace, en met inhibit-regels. Valt de database weg, dan wil je één melding over de database, niet daarnaast nog tien over trage pagina's. Alle regels staan als PrometheusRule-resources in Git, naast de applicatie die ze bewaken.
| Alert | Signaal | Urgentie | Eerste actie |
|---|---|---|---|
| Checkout traag | p95-latency van checkout-routes boven je afgesproken drempel, 10 minuten lang | Direct | Trace of logregels van trage requests openen, PHP-FPM-wachtrij checken |
| Orders vallen stil | Orders per kwartier ver onder dezelfde periode vorige week | Direct | Betaalprovider, checkout-fouten en recente deploys checken |
| PHP-FPM verzadigd | Listen queue boven nul of max children reached op meerdere pods | Hoog | Replicas en pm.max_children naast geheugenlimiet bekijken |
| Queue loopt achter | Oudste bericht in een kritieke queue ouder dan de afgesproken wachttijd | Hoog | Consumers of Horizon-workers checken, foutende jobs bekijken |
| Cron stil | Geen geslaagde run van een kritieke cronjob binnen het verwachte venster | Hoog | CronJob-historie en cron_schedule bekijken, locks controleren |
| Cache-hit-ratio gezakt | Varnish-hit-ratio fors lager dan het weekgemiddelde | Middel | Recente deploys, purges en cookies in responses checken |
| Pods crashen | Herstarts of OOMKilled-events boven drempel per kwartier | Middel | Logs van vorige container, geheugenlimiet versus werkelijk gebruik |
| Certificaat verloopt | cert-manager-certificaat verloopt binnen 14 dagen | Middel | Certificate- en Order-status in cert-manager bekijken |
Logs met Loki en Grafana Alloy: zoeken zonder Elasticsearch-cluster
Loki slaat logs op zonder de volledige tekst te indexeren. Het indexeert alleen labels zoals namespace, app en container, en zet de logregels zelf gecomprimeerd op object storage. Dat maakt het goedkoper in beheer dan een eigen Elasticsearch- of OpenSearch-cluster voor logs. Zoeken in de tekst gebeurt bij het opvragen, met LogQL.
De collector is Grafana Alloy, als DaemonSet op elke node. Promtail is door Grafana op 2 maart 2026 end-of-life verklaard. Bestaande Promtail-configuraties zetten we om met de conversietool van Alloy. Alloy kan tegelijk OTLP-traces ontvangen, zodat je één agent per node hebt in plaats van drie.
Het belangrijkste werk zit in de applicatie. Magento en Laravel schrijven standaard naar bestanden in var/log of storage/logs. In een container willen we logs op stdout, gestructureerd als JSON. Bij Laravel is dat een kanaal met de stderr-driver en een JSON-formatter. Bij Magento passen we de Monolog-handlers aan via di.xml. Daarna voegen we een trace-ID toe aan elke regel, zodat je vanuit een foutmelding in Loki direct naar de trace springt.
Labels houden we bewust klein. Order-ID's, klant-ID's en URL's horen in de logregel, niet in een label. Elk uniek label maakt een nieuwe stream, en duizenden streams maken Loki traag. Meer over wat je uit security-oogpunt moet loggen staat in ons artikel over security logging.
OpenTelemetry: traces voor als je wilt weten waar de tijd heen gaat
Metrics vertellen dat de checkout traag is. Een trace vertelt dat 2,1 seconde van de 2,4 in één call naar het ERP zat. OpenTelemetry is de open standaard voor zulke traces. Voor PHP bestaat een extensie die automatisch spans maakt voor frameworks, PDO, HTTP-clients en Redis-calls, aangevuld met de SDK voor eigen spans.
We voegen de extensie toe in het container-image en sturen de traces via OTLP naar Alloy of een OpenTelemetry Collector. Van daaruit gaan ze naar Tempo, Jaeger of een commerciële backend. Sampling stellen we bewust in: alle trage en foutieve requests bewaren, van de rest een fractie. Anders groeit je trace-opslag sneller dan je omzet.
Moet je met traces beginnen? Niet altijd. Een Magento-monoliet met goede metrics en logs heeft er minder aan dan een Laravel-platform met vijf services die elkaar aanroepen. Bij microservices wordt het snel onmisbaar. Bij twijfel beginnen we met metrics en logs, en voegen we traces toe op de routes die geld opleveren.
Server-side metrics en RUM: twee kanten van dezelfde checkout
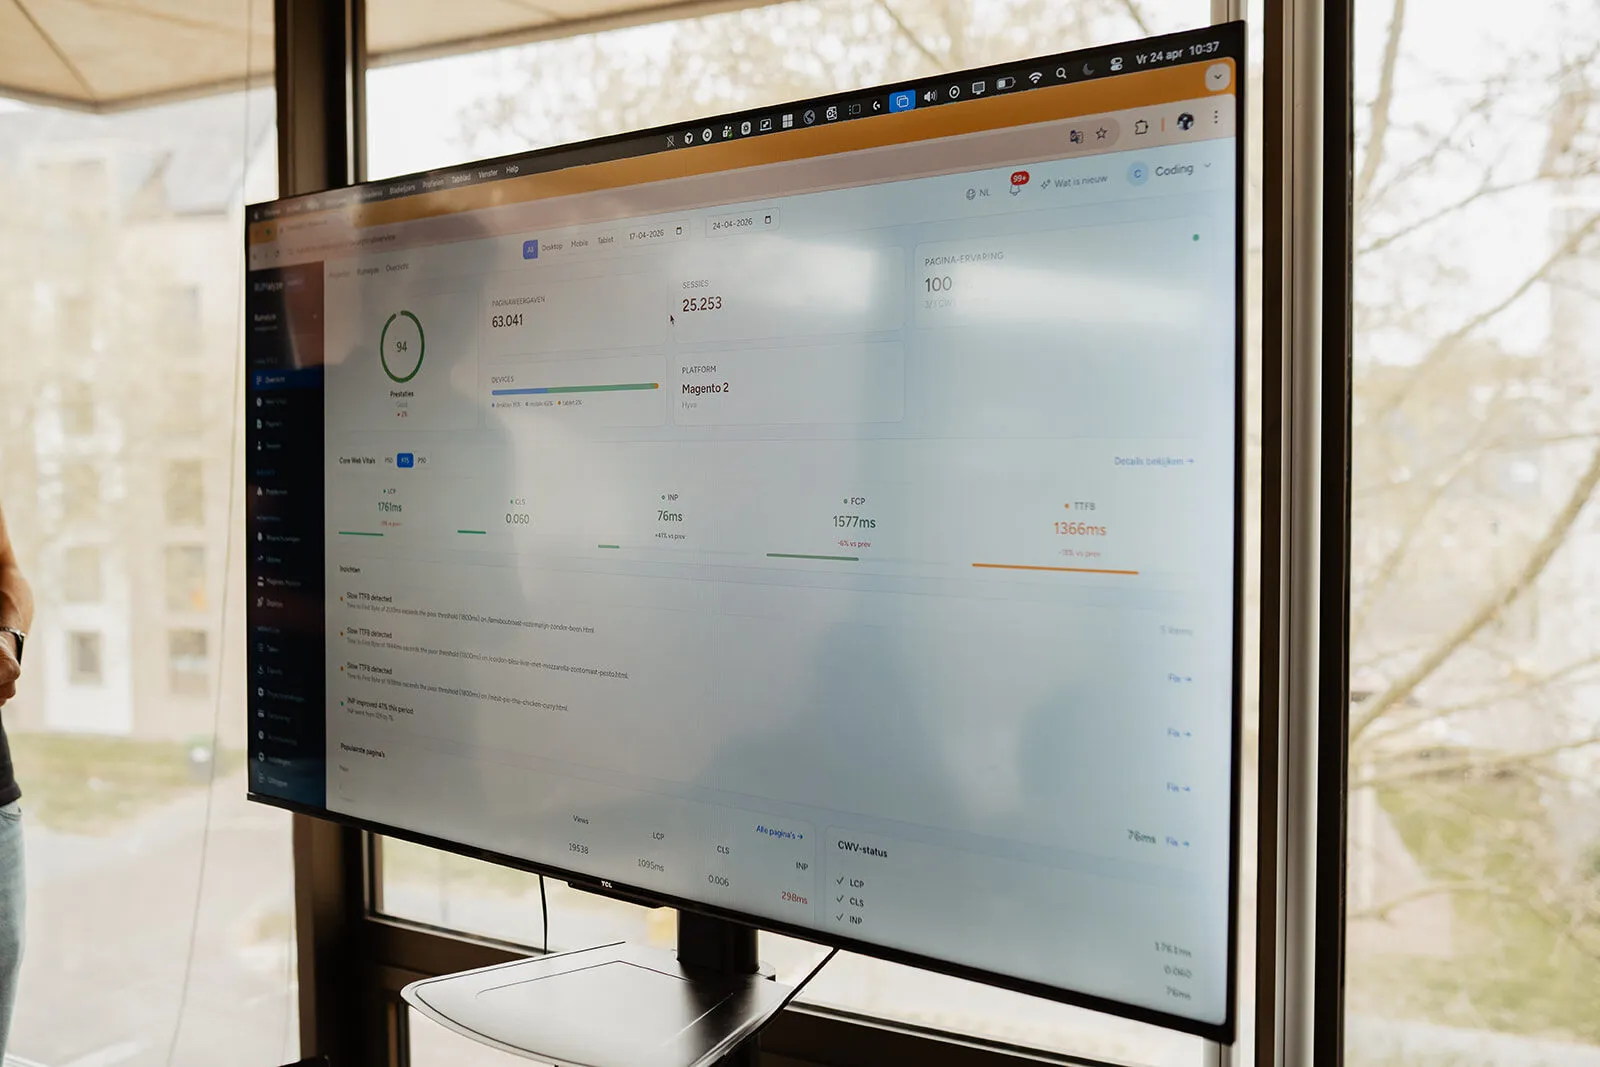
Prometheus meet wat je servers doen. Het meet niet wat je bezoeker ervaart. Tussen een responstijd van 200 milliseconden in het cluster en een pagina die op een middenklasse-telefoon interactief wordt, zitten CDN, netwerk, JavaScript en afbeeldingen. Daarvoor heb je real user monitoring nodig.
Als RUMvision Gold Partner koppelen we die twee. RUMvision meet Core Web Vitals en laadtijden bij echte bezoekers, per paginatype en apparaat. Wij leggen een deploy-marker in zowel Grafana als RUMvision. Zakt de INP op de productpagina na een release, dan zie je in Grafana of de server veranderde of dat het aan de frontend ligt.
In de praktijk vangt RUM problemen die serverside onzichtbaar blijven: een tracking-script dat de main thread blokkeert, een afbeelding zonder afmetingen, een Varnish-miss die alleen mobiele bezoekers raakt. En andersom laten servermetrics zien waarom de TTFB in RUM ineens oploopt. Lees ook ons stuk over Core Web Vitals voor wat je in RUM terugziet.
Zelf hosten of SaaS: de eerlijke afweging
Zelf hosten in het cluster
kube-prometheus-stack, Loki en Grafana in je eigen cluster. Geen kosten per host of per GB, wel opslag, onderhoud en upgrades. Past als je data in de EU wilt houden en het platform toch al beheert.
Lees verder →Grafana Cloud of vergelijkbare SaaS
Dezelfde open standaarden, maar zonder opslag en schaalbeheer. Je betaalt per volume metrics, logs en traces. Past bij een klein platform of een team zonder tijd voor de monitoring-stack zelf.
Lees verder →APM zoals New Relic of Datadog
Sterke out-of-the-box inzichten in PHP, met agents en kant-en-klare dashboards. De kosten schalen met hosts en volume. Zinvol als je diepe APM wilt zonder zelf OpenTelemetry in te richten.
Lees verder →Hybride
Metrics en alerts zelf in het cluster, logs en traces bij een SaaS-backend via OpenTelemetry. Omdat alles via open protocollen loopt, wissel je later zonder je applicaties aan te passen.
Lees verder →Onze aanpak van Kubernetes monitoring
Vijf stappen. Het vaste team dat je platform bouwt, richt ook de monitoring in en reageert op de alerts.
- 1
Inventarisatie
Welke processen leveren omzet op, welke koppelingen zijn kritiek en wat ging er de afgelopen tijd mis? Daar bepalen we de bovenste laag metrics op.
- 2
Stack uitrollen als code
kube-prometheus-stack, Loki, Alloy en Grafana via Helm en Argo CD, met retentie en opslag passend bij je volume.
- 3
Applicatie instrumenteren
Exporters voor PHP-FPM, Varnish, Valkey, database en queues. JSON-logs op stdout, trace-ID's en waar zinvol OpenTelemetry.
- 4
Alerts en dashboards
PrometheusRules met drempels die we onderbouwen, routing in Alertmanager en per alert een runbook. Dashboards als JSON in Git.
- 5
Bijstellen na de eerste weken
Alerts die te vaak afgaan of iets missen, passen we aan. Daarna bespreken we periodiek wat de data laat zien.
Wat je opgeleverd krijgt
- Monitoring-stack als Helm values en Argo CD Applications in je GitOps-repository
- Exporters en ServiceMonitors voor PHP-FPM, Varnish, Valkey, database, OpenSearch en queues
- Gestructureerde JSON-logging voor Magento of Laravel, met trace-ID per regel
- Set PrometheusRules met drempels, urgentie en runbook-link per alert
- Alertmanager-routing naar je kanalen, met groepering en inhibit-regels
- Grafana-dashboards voor bedrijf, applicatie, afhankelijkheden en cluster
- Deploy-markers in Grafana en RUMvision
- Documentatie van retentie, opslag en de kostenposten van de stack
Waarom Coding.nl voor Kubernetes monitoring
We kennen de applicatie, niet alleen het cluster
Wij bouwen Magento- en Laravel-platformen. Daardoor weten we welke cronjob, queue of PHP-FPM-instelling je shop stillegt.
RUMvision Gold Partner
We combineren servermetrics met data van echte bezoekers, zodat je weet of een probleem in het cluster of in de browser zit.
Geen tussenlagen
Gaat er een alert af, dan kijkt iemand die het platform heeft gebouwd. Geen ticket dat drie keer wordt doorgezet.
Open standaarden
Prometheus, OpenTelemetry en Loki. Wil je later naar een SaaS-backend of een andere partij, dan neem je alles mee.
Verder lezen
- ›Webshop monitoring op Kubernetes: Prometheus, Grafana en Loki
- ›Magento 2 monitoring — wat je moet meten en waarom
- ›Laravel Horizon — queue monitoring voor bedrijfskritische processen
- ›New Relic vs Datadog voor Magento — APM monitoring
- ›Coding.nl is RUMvision Gold Partner: waarom we meten bij echte bezoekers
- ›Security logging voor webshops: wat log je en wanneer gaat er een alarm af?
- ›Incident response plan webshop: monitoring en draaiboek
- ›Laravel-queues automatisch schalen met KEDA
- ›Magento 2 op Kubernetes: de architectuur per component
- ›Core Web Vitals in 2026: wat telt voor e-commerce?
Veelgestelde vragen
Meer over Kubernetes
Weten of je monitoring de juiste dingen ziet?
Plan een gesprek. We bekijken je huidige dashboards en alerts, en vertellen eerlijk welke incidenten je nu zou missen en wat er nodig is om ze wel te zien.