Inhoud van dit artikel
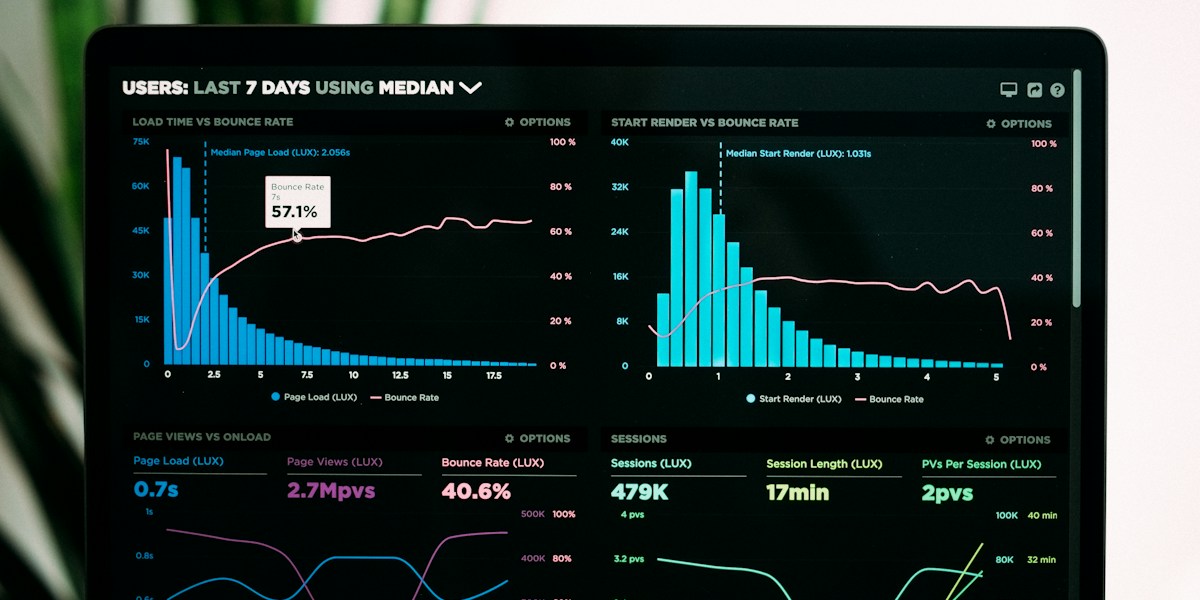
Voor een webshop op Kubernetes is de standaard open-source stack: Prometheus voor metrics, Loki voor logs, Grafana om beide te bekijken en Alertmanager om je wakker te maken. Installeer kube-prometheus-stack voor de basis, Loki via de grafana-community Helm-chart en Grafana Alloy als logcollector, want Promtail is sinds 2 maart 2026 end-of-life. De echte waarde zit niet in de installatie maar in wat je meet: PHP-FPM-capaciteit, queue-achterstand, cron-gezondheid en foutpercentages op de checkout.
Wat je eigenlijk wilt weten
Een Kubernetes-cluster levert duizenden metrics. De meeste ervan zijn ruis voor een webshop. De vragen die ertoe doen:
- Verkoopt de shop? Werken homepage, zoeken, winkelwagen en checkout?
- Is er capaciteit? Heeft PHP-FPM vrije workers, zit Varnish vol, is de database traag?
- Loopt het achtergrondwerk? Draait de cron, worden queues weggewerkt, lopen imports?
- Wat ging er mis? Welke foutmelding, welke pod, welk request?
De eerste drie zijn metrics. De laatste is logs. Daarom heb je beide nodig.
Wat je niet uit Prometheus haalt: hoe snel de shop voor echte bezoekers is. Server-side metrics zien niet wat de browser doet. Daarvoor heb je Real User Monitoring nodig. Wij gebruiken daarvoor RUMvision; meer over de metrics die tellen op Core Web Vitals.
De stack
| Component | Rol |
|---|---|
| Prometheus | Haalt metrics op (scrape) en slaat ze op |
| Prometheus Operator | Beheert Prometheus via CRD's als ServiceMonitor en PrometheusRule |
| Alertmanager | Groepeert alerts en stuurt ze naar Slack, mail of een pager |
| kube-state-metrics | Metrics over Kubernetes-objecten: pods, deployments, cronjobs |
| node-exporter | Metrics van de nodes: CPU, geheugen, schijf |
| Grafana | Dashboards en verkenning van metrics en logs |
| Loki | Logopslag, geïndexeerd op labels, data in object storage |
| Grafana Alloy | Verzamelt logs (en eventueel metrics en traces) en stuurt ze door |
De eerste vijf plus Grafana zitten samen in één Helm-chart: kube-prometheus-stack van de prometheus-community.
Stap 1: kube-prometheus-stack
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update

helm upgrade --install monitoring prometheus-community/kube-prometheus-stack \
  -n monitoring --create-namespace \
  -f values-monitoring.yaml
Een minimale values-monitoring.yaml met de keuzes die we bijna altijd maken:
prometheus:
  prometheusSpec:
    retention: 15d
    retentionSize: 40GB
    serviceMonitorSelectorNilUsesHelmValues: false
    ruleSelectorNilUsesHelmValues: false
    storageSpec:
      volumeClaimTemplate:
        spec:
          accessModes: ["ReadWriteOnce"]
          resources:
            requests:
              storage: 50Gi

alertmanager:
  config:
    route:
      receiver: slack
      group_by: ["alertname", "namespace"]
    receivers:
      - name: slack
        slack_configs:
          - api_url_file: /etc/alertmanager/secrets/slack/url
            channel: "#shop-alerts"
            send_resolved: true
  alertmanagerSpec:
    secrets: ["slack"]

grafana:
  admin:
    existingSecret: grafana-admin
Twee instellingen verdienen uitleg:
serviceMonitorSelectorNilUsesHelmValues: falsezorgt dat Prometheus ook ServiceMonitors oppikt die niet door deze Helm-release zijn gemaakt. Zonder deze regel vraag je je een middag af waarom je PHP-FPM-metrics niet verschijnen.- De Slack-webhook en het Grafana-wachtwoord komen uit Secrets, niet uit de values. Hoe je die Secrets beheert, lees je in Secrets met External Secrets Operator.
Pin de chartversie in Git. kube-prometheus-stack brengt vaak nieuwe major-versies uit, en majors kunnen CRD-wijzigingen bevatten die je handmatig moet toepassen.
Stap 2: metrics van je eigen applicatie
Kubernetes weet dat je pod draait. Het weet niet hoeveel PHP-FPM-workers bezet zijn. Daarvoor zet je exporters naast je applicatie.
Voor een Magento- of Laravel-stack de gebruikelijke set:
- PHP-FPM: een exporter als sidecar die de FPM-statuspagina leest, bijvoorbeeld
hipages/php-fpm_exporter. - Varnish: een Varnish-exporter als sidecar.
- Valkey of Redis:
redis_exporter, werkt voor beide. - MySQL/MariaDB:
mysqld_exporter, of de metrics van je managed database. - OpenSearch: een OpenSearch-exporter of de ingebouwde metrics van je managed dienst.
De PHP-FPM-sidecar in je Deployment:
containers:
  - name: php-fpm
    image: registry.example.nl/shop/php-fpm:2026.10.3
  - name: fpm-exporter
    image: hipages/php-fpm_exporter:2
    env:
      - name: PHP_FPM_SCRAPE_URI
        value: "tcp://127.0.0.1:9000/status"
    ports:
      - name: fpm-metrics
        containerPort: 9253
Zet in je FPM-pool pm.status_path = /status, en zorg dat die URL niet via de webserver naar buiten bereikbaar is.
Daarna vertel je Prometheus waar hij moet kijken met een ServiceMonitor:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: shop-php-fpm
  namespace: shop
spec:
  selector:
    matchLabels:
      app: shop-php
  endpoints:
    - port: fpm-metrics
      interval: 30s
Stap 3: logs met Loki en Alloy
Loki indexeert logs niet op inhoud, alleen op labels zoals namespace, pod en container. De logregels zelf gaan gecomprimeerd naar object storage. Dat houdt het goedkoop en eenvoudig, mits je je labels beperkt houdt.
Twee wijzigingen uit 2026 die je moet weten:
- De Loki Helm-chart is verhuisd. Sinds 16 maart 2026 onderhoudt de community de chart in
grafana-community/helm-charts. De chart in de Loki-repository krijgt alleen nog onderhoud voor Enterprise-gebruikers. De versienummering is veranderd, dus vergelijk majors niet met de oude chart. - Promtail is end-of-life. Sinds 2 maart 2026. Grafana Alloy is de opvolger. Er is een conversietool om bestaande Promtail-configuratie om te zetten.
Voor de meeste webshops volstaat Loki in monolithische modus:
helm repo add grafana-community https://grafana-community.github.io/helm-charts
helm repo update
helm upgrade --install loki grafana-community/loki \
-n loki --create-namespace -f values-loki.yamldeploymentMode: Monolithic
loki:
commonConfig:
replication_factor: 1
schemaConfig:
configs:
- from: "2026-01-01"
store: tsdb
object_store: s3
schema: v13
index:
prefix: loki_index_
period: 24h
limits_config:
retention_period: 720h
storage:
type: s3
bucketNames:
chunks: shop-loki-chunks
ruler: shop-loki-ruler
admin: shop-loki-admin
s3:
region: eu-central-1
minio:
enabled: false
singleBinary:
replicas: 1Gebruik externe object storage, niet de meegeleverde MinIO-subchart. Die is deprecated en wordt per 31 oktober 2026 verwijderd. In de officiële voorbeelden staan nog andere replica-instellingen voor de overige componenten op 0; neem die over uit de documentatie van je chartversie.
Alloy verzamelt de logs van alle pods en stuurt ze naar Loki. De kern van de configuratie:
discovery.kubernetes "pods" {
  role = "pod"
}

discovery.relabel "pods" {
  targets = discovery.kubernetes.pods.targets

  rule {
    source_labels = ["__meta_kubernetes_namespace"]
    target_label  = "namespace"
  }
  rule {
    source_labels = ["__meta_kubernetes_pod_container_name"]
    target_label  = "container"
  }
  rule {
    source_labels = ["__meta_kubernetes_pod_label_app"]
    target_label  = "app"
  }
}

loki.source.kubernetes "pods" {
  targets    = discovery.relabel.pods.output
  forward_to = [loki.write.default.receiver]
}

loki.write "default" {
  endpoint {
    url = "http://loki-gateway.loki.svc/loki/api/v1/push"
  }
}
Maak geen labels van waarden met veel varianten, zoals URL's, order-ID's of klant-ID's. Dat maakt Loki traag. Zulke velden filter je bij het zoeken uit de logregel.
Logs die je kunt doorzoeken
Loki wordt pas nuttig als je logs gestructureerd zijn. Laat je webserver JSON loggen, dan kun je in Grafana met LogQL direct filteren:
sum by (status) (
  count_over_time({namespace="shop", container="nginx"} | json | status >= 500 [5m])
)
Twee praktische punten:
- Magento schrijft standaard naar
var/log/in de container. In Kubernetes wil je die logs op stdout. Dat kan via een eigen Monolog-handler of door de logbestanden te streamen. Logs die alleen in een container staan, zijn weg bij de volgende herstart. Hoe de rest van zo'n Magento-stack eruitziet, lees je op Magento 2 op Kubernetes. - Laravel kan met het
stderr-kanaal en een JSON-formatter direct naar stdout loggen. ZetLOG_CHANNEL=stderrin je omgeving.
De alerts die we altijd instellen
Een dashboard kijkt niemand om drie uur 's nachts. Alerts wel. Begin met weinig alerts die allemaal actie vereisen. Een kanaal dat de hele dag piept, wordt genegeerd.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: shop-alerts
  namespace: shop
spec:
  groups:
    - name: shop
      rules:
        - alert: PhpFpmMaxChildrenReached
          expr: increase(phpfpm_max_children_reached[10m]) > 0
          for: 5m
          labels:
            severity: warning
          annotations:
            summary: "PHP-FPM in {{ $labels.pod }} zit aan zijn maximum aantal workers"

        - alert: PhpFpmListenQueue
          expr: phpfpm_listen_queue > 0
          for: 5m
          labels:
            severity: critical
          annotations:
            summary: "Requests wachten op een vrije PHP-FPM-worker"

        - alert: CronJobNotSucceeded
          expr: time() - kube_cronjob_status_last_successful_time{namespace="shop"} > 1800
          labels:
            severity: critical
          annotations:
            summary: "CronJob {{ $labels.cronjob }} is al 30 minuten niet geslaagd"

        - alert: PodCrashLooping
          expr: increase(kube_pod_container_status_restarts_total{namespace="shop"}[15m]) > 3
          labels:
            severity: warning

        - alert: CertificateExpiringSoon
          expr: certmanager_certificate_expiration_timestamp_seconds - time() < 14 * 24 * 3600
          labels:
            severity: warning
Wat elke alert vangt:
- Max children / listen queue: de shop heeft meer verkeer dan PHP-FPM aankan. Bezoekers wachten of krijgen een 502. Dit is ook het signaal voor autoscaling.
- CronJob niet geslaagd: bij Magento draaien indexers, e-mails en geplande prijzen via de cron. Een stille cron merk je pas als klanten bellen.
- CrashLoop: vaak een configuratiefout na een deploy.
- Certificaat verloopt: cert-manager vernieuwt automatisch, tot het een keer niet lukt.
Voeg daar een queue-alert aan toe. Bij Laravel lees je de lengte van de Horizon-queues uit Redis of Valkey; met redis_exporter en de optie -check-keys krijg je de lengte van lijsten als metric. Bij Magento kijk je naar de consumers die via RabbitMQ of de database lopen. Meer over Horizon in Laravel Horizon queue monitoring.
Synthetische checks op de checkout
Interne metrics zeggen dat alles groen is. De klant ziet een foutmelding. Dat gebeurt, bijvoorbeeld als een betaalprovider-integratie faalt of een DNS-record verkeerd staat.
Met de Prometheus blackbox-exporter test je van buitenaf:
apiVersion: monitoring.coreos.com/v1
kind: Probe
metadata:
  name: shop-pages
  namespace: monitoring
spec:
  prober:
    url: blackbox-exporter.monitoring.svc:9115
  module: http_2xx
  targets:
    staticConfig:
      static:
        - https://www.voorbeeldshop.nl/
        - https://www.voorbeeldshop.nl/checkout/cart/
        - https://www.voorbeeldshop.nl/customer/account/login/
Draai deze checks bij voorkeur ook vanaf een locatie buiten je cluster. Als het cluster zelf onbereikbaar is, kan het dat niet melden.
Waar het geld zit
Monitoring kost geld, ook als de software gratis is. De kostenposten:
- Opslag van metrics: Prometheus-volumes groeien met het aantal series en de retentie.
- Object storage voor logs: gering per gigabyte, maar debug-logging in productie vult het snel.
- Rekenkracht: Prometheus en Loki hebben geheugen nodig, vooral bij veel labels.
- Tijd: dashboards en alerts onderhouden is doorlopend werk.
Grafana Cloud of een andere hosted dienst neemt het beheer over tegen een maandbedrag. Self-hosted is goedkoper in licenties en duurder in tijd. Een APM-tool als New Relic of Datadog geeft daarnaast code-level inzicht; die afweging maakten we in New Relic vs Datadog voor Magento.
Meer over traces met OpenTelemetry en de keuzes rond retentie staat op Monitoring en logging op Kubernetes. Wil je dat het vaste team dit voor je platform inricht en meedraait? Neem contact op.
Veelgestelde vragen
Moet ik nog Promtail gebruiken?+
Nee. Promtail is sinds 2 maart 2026 end-of-life. Gebruik Grafana Alloy. Grafana levert een conversietool waarmee je een bestaande Promtail-configuratie omzet naar Alloy.
Waar vind ik de Loki Helm-chart nu?+
In de grafana-community/helm-charts-repository, sinds maart 2026. De chart in de Loki-repository zelf is er alleen nog voor Enterprise-gebruikers. Let op dat de versienummering anders is.
Is Loki geschikt voor een enkele webshop?+
Ja, in monolithische modus met object storage is Loki licht genoeg. Houd het aantal labels beperkt en zet een retentie die past bij wat je echt terugzoekt, bijvoorbeeld 30 dagen.
Welke metrics zijn voor een Magento-shop het belangrijkst?+
PHP-FPM-capaciteit (listen queue en max children), foutpercentages van de webserver, de status van cron en queue-consumers, Varnish hit rate en databaselatentie. Voor de ervaring van bezoekers heb je daarnaast Real User Monitoring nodig.
Self-hosted of Grafana Cloud?+
Self-hosted geeft volledige controle en geen licentiekosten, maar kost beheertijd. Een hosted dienst neemt dat beheer over tegen een maandbedrag dat meegroeit met je datavolume. Voor een klein platform is hosted vaak de eenvoudigste start.